Modelos de lenguaje
Define longitud de entrada y salida, concurrencia y objetivos de respuesta para tu asistente o servicio interno.
Configuramos servidores y estaciones de trabajo para desplegar inferencia de IA según el modelo, los usuarios simultáneos y los tiempos de respuesta requeridos. Una propuesta de hardware adaptada al servicio y a la infraestructura de tu organización.
Ensamblaje y pruebas en España · Soporte directo · Propuesta a medida
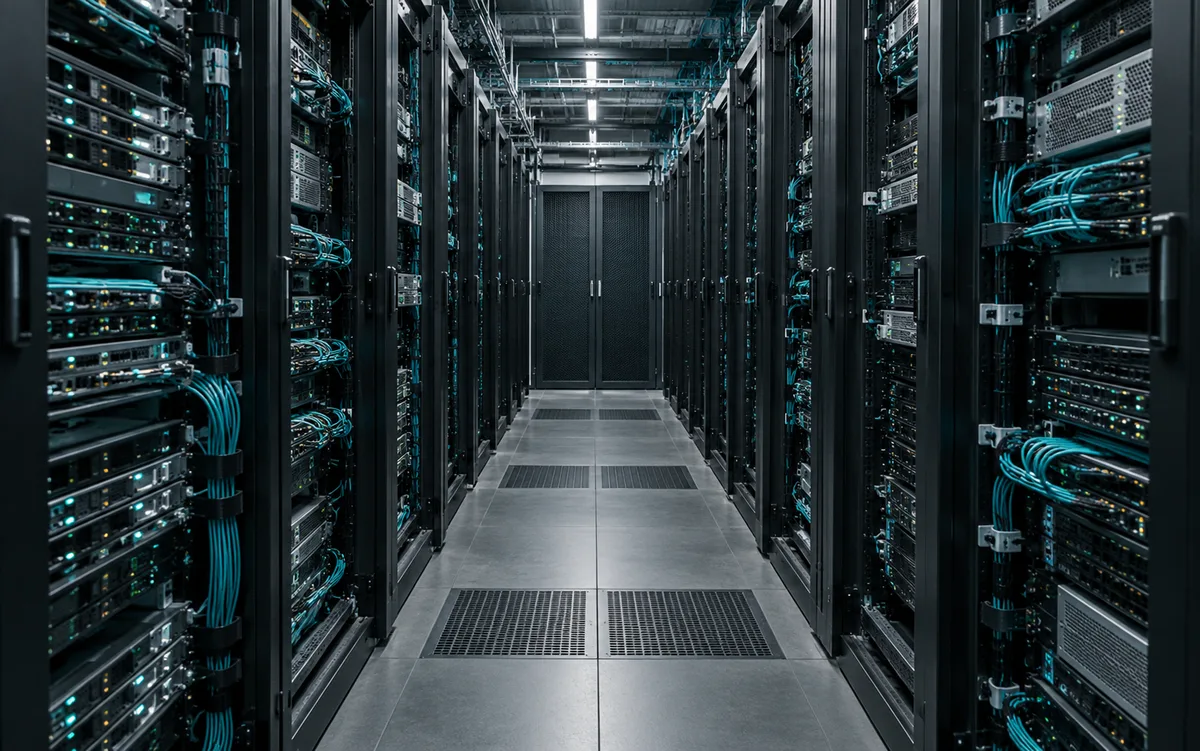
Un modelo que funciona para una persona puede comportarse de otra manera al recibir peticiones concurrentes. Estudiamos la carga prevista, las entradas y salidas y el entorno de despliegue para concretar la capacidad necesaria.
Define longitud de entrada y salida, concurrencia y objetivos de respuesta para tu asistente o servicio interno.
Describe imágenes, vídeo, lotes y frecuencia de procesamiento para dimensionar el sistema.
Diferencia trabajos programados y servicios interactivos para distribuir capacidad y ventanas de ejecución.
| Componente | Qué estudiamos | Por qué importa |
|---|---|---|
| GPU y memoria | Modelo, precisión, lotes y peticiones simultáneas. | La capacidad debe estudiarse bajo la carga prevista, no solo al cargar el modelo. |
| CPU y RAM | Preprocesamiento, colas, servicios auxiliares y datos de entrada. | El servicio completo puede limitarse en componentes distintos a la GPU. |
| Almacenamiento | Modelos, datos, registros y recursos temporales. | Dimensionamos capacidad y acceso según los flujos del servicio. |
| Red | Origen de las peticiones y movimiento de datos. | Se revisan conexiones y necesidades de integración con el entorno existente. |
| Formato y operación | Torre o rack, consumo, refrigeración y acceso para mantenimiento. | La instalación física condiciona la plataforma y las posibilidades de crecimiento. |
La configuración final se concreta en el presupuesto. Las aplicaciones, licencias y servicios incluidos se detallan en cada propuesta.
Antes de concretar el hardware, conviene definir qué significa una respuesta aceptable: latencia, peticiones por unidad de tiempo, concurrencia y tamaño de las entradas. Si dispones de pruebas de carga o consumos del entorno actual, sirven para delimitar la propuesta. Los servicios de despliegue, monitorización y mantenimiento se acuerdan por separado en su alcance.
Aplicaciones, carga de trabajo, entorno y prioridades de tu organización.
Configuración y presupuesto con componentes, alcance y condiciones de entrega.
Ensamblaje y pruebas del equipo, con soporte técnico directo.
Puede ser una opción según la carga, pero hay que revisar concurrencia, operación y requisitos del servicio. El formato servidor se estudia cuando el entorno lo requiere.
No hay una cifra universal. Depende del modelo, contexto, precisión, tamaño de las respuestas y motor utilizado. La capacidad se debe valorar con una carga representativa.
Puede compartir componentes, pero entrenamiento e inferencia tienen prioridades diferentes. También debe evaluarse cómo competirían ambas tareas por los recursos.
Solo si se define expresamente una arquitectura y un alcance para ello. Un servidor individual no equivale por sí mismo a un servicio de alta disponibilidad.
Sí. Estudiamos margen de memoria, almacenamiento, conexiones y GPU, dentro de los límites físicos y eléctricos de la plataforma.
Las estrategias de distribución dependen del entorno de ejecución. Puede consultarse como referencia Hugging Face: inferencia distribuida.
Relaciona esta aplicación con el resto de tu trabajo antes de cerrar la configuración.
Preparamos tu propuesta de Inferencia de IA.
Desde una workstation hasta varios equipos para tu organización. Cuéntanos en qué trabajas, aunque todavía no tengas una configuración definida.
613 004 811Lunes a viernes · 9:30–17:00 · España y UEConsulta las configuraciones de IA disponibles en JD Gaming. Para inferencia en producción, revisamos contigo concurrencia, memoria, formato e instalación.
Consulta las configuraciones de IA, su memoria y sus opciones de GPU.
Ver ordenadores para Inteligencia artificial en JD GamingJD Workstation y JD Gaming son marcas de Join Digital S.L. Aquí preparamos tu propuesta a medida; en JD Gaming puedes consultar el catálogo y comprar online.
Ver todo el catálogo de workstations