Workstations para inteligencia artificial y computación científica
Diseñamos workstations y servidores a medida para ejecutar modelos de IA, analizar datos y resolver cargas de cálculo científico. Propuestas para empresas, universidades, centros de investigación y organismos, ajustadas al software y al presupuesto de cada proyecto.
Ensamblaje y pruebas en España · Soporte directo · Propuesta a medida
Primero el modelo y los datos. Después, el hardware.
Elegir una workstation para inteligencia artificial empieza por concretar qué vas a ejecutar. La inferencia de un modelo de lenguaje, el ajuste de una red neuronal y una simulación numérica tienen necesidades diferentes. Estudiamos capacidad de memoria, compatibilidad del entorno y trabajo simultáneo antes de proponer componentes.
LLM e IA generativa local
Para asistentes internos, pruebas con modelos de lenguaje y generación de imágenes. Revisamos el modelo, la cuantización, la longitud de contexto y los usuarios simultáneos. El objetivo es dimensionar la memoria y el rendimiento para tu uso concreto.
Machine learning y análisis de datos
Para desarrollo, experimentación y procesamiento de conjuntos de datos. Valoramos la preparación de datos en CPU, la memoria del sistema, el almacenamiento y la aceleración GPU que utiliza tu biblioteca.
Computación científica y simulación
Para laboratorios y equipos de investigación con cargas intensivas. La elección depende del solver, la precisión numérica, el paralelismo y el volumen de resultados. No todas las GPU ofrecen el mismo rendimiento en cada tipo de cálculo.
Soluciones para IA local e infraestructura de cálculo
Cómo dimensionamos tu workstation de IA
| Componente | Qué estudiamos | Por qué importa |
|---|---|---|
| GPU y VRAM | Tamaño del modelo, precisión, contexto, lotes y memoria de ejecución. | No basta con comprobar que los pesos caben: el proceso necesita memoria adicional. |
| Varias GPU | Compatibilidad del software, reparto del modelo y comunicación entre tarjetas. | La VRAM de varias tarjetas no se convierte automáticamente en una sola memoria compartida. |
| CPU y RAM | Preparación de datos, procesos simultáneos y necesidades del código científico. | Una GPU potente puede quedar limitada si el resto del sistema no alimenta la carga. |
| Almacenamiento | Capacidad para datasets, modelos, checkpoints y resultados. | Separamos espacio de trabajo y estrategia de copia de seguridad según el proyecto. |
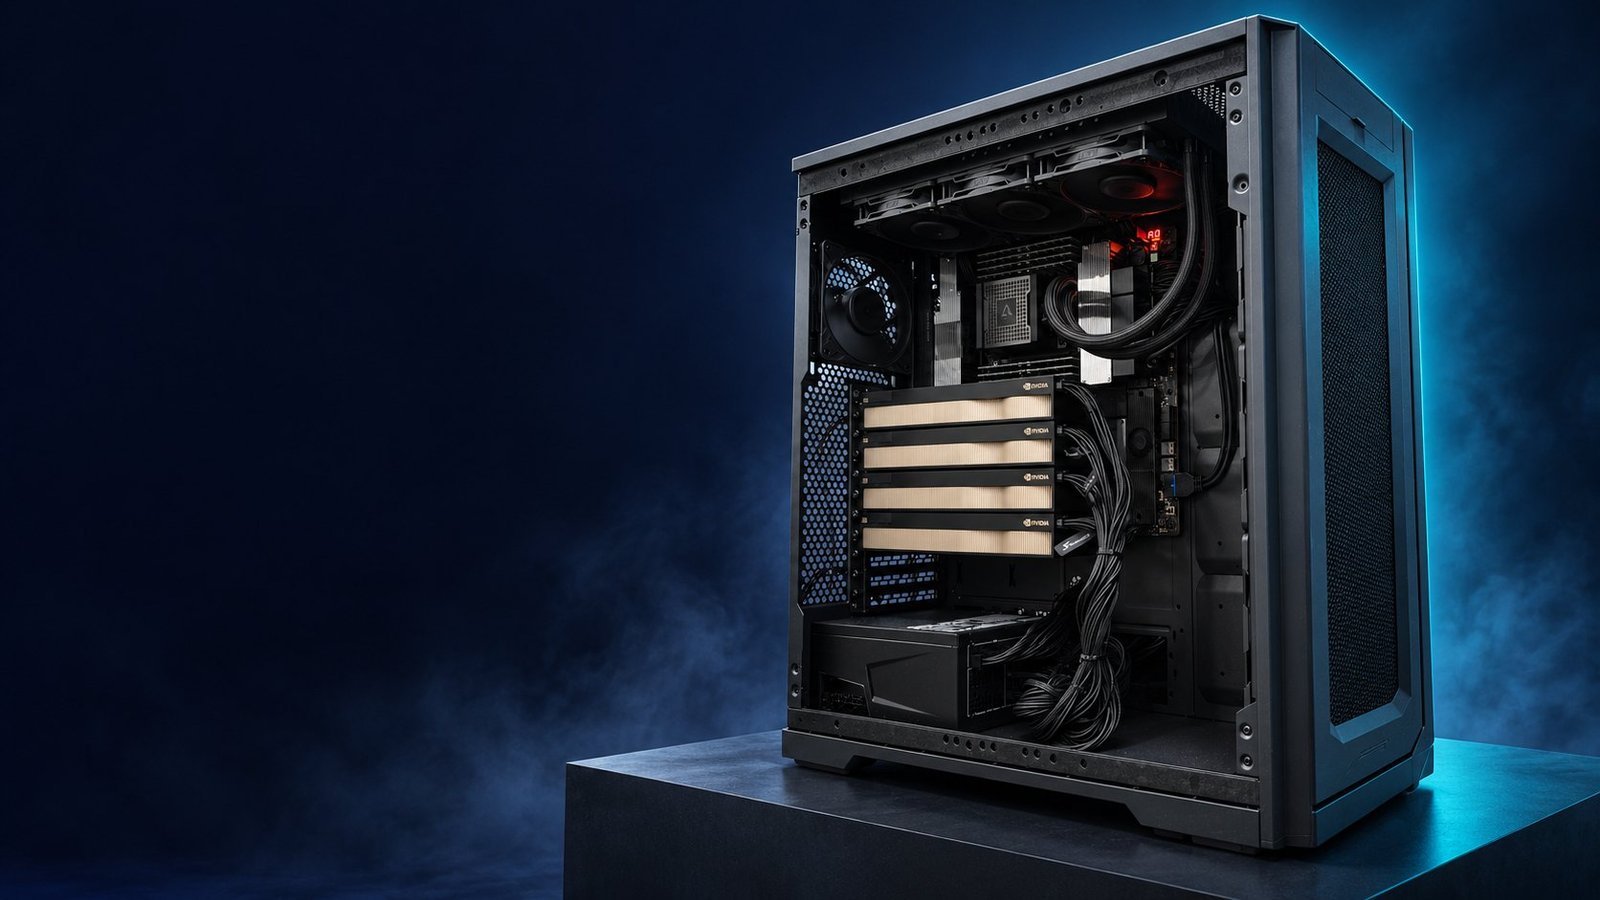
| Plataforma y chasis | Líneas PCIe, alimentación, refrigeración, dimensiones y ampliación. | Torre o rack según la instalación, el ruido admisible y los usuarios. |
La configuración final se concreta en el presupuesto. Las aplicaciones, licencias y servicios incluidos se detallan en cada propuesta.
Workstation de sobremesa o servidor de IA
Una torre puede encajar en el puesto de un investigador o desarrollador. Un servidor puede ser más adecuado si varios usuarios acceden de forma remota o si el equipo se instala en un rack. Antes de decidir, revisamos la alimentación disponible, la ventilación, el espacio y las necesidades de administración. La propuesta identifica el hardware y el alcance del suministro; la instalación del entorno, las licencias y otros servicios se concretan por separado.
Qué necesitamos para preparar tu propuesta
- Nombre y versión del modelo o del software; framework y sistema operativo.
- Inferencia, ajuste, entrenamiento o cálculo; prioridad entre tiempo de respuesta y volumen de trabajo.
- Tamaño de los datos, contexto, precisión y usuarios simultáneos.
- Número de equipos, formato, ampliaciones previstas, presupuesto y fecha objetivo.
01 · Revisamos requisitos
Aplicaciones, carga de trabajo, entorno y prioridades de tu organización.
02 · Proponemos el sistema
Configuración y presupuesto con componentes, alcance y condiciones de entrega.
03 · Montamos y probamos
Ensamblaje y pruebas del equipo, con soporte técnico directo.
Preguntas frecuentes sobre IA y computación científica
¿Cuánta VRAM necesito para un modelo de lenguaje?
Depende del tamaño y la precisión de los pesos, la cuantización, el contexto y la concurrencia. También hay que reservar memoria para la caché y otras operaciones. Envíanos el modelo y cómo quieres utilizarlo para valorar una configuración; una cifra de parámetros por sí sola no determina toda la memoria necesaria.
¿Dos GPU duplican la memoria disponible para un modelo?
No de forma automática. El programa debe admitir el reparto del modelo o de la carga entre dispositivos. Algunas estrategias mantienen una copia completa en cada GPU; otras distribuyen partes del modelo. Revisamos esa compatibilidad antes de recomendar un sistema multi-GPU.
¿Puedo ejecutar IA local sin enviar mis datos a un servicio externo?
Un despliegue local permite ejecutar el modelo en tu infraestructura. El tratamiento de los datos también depende de la aplicación, sus conexiones, la configuración y los permisos. Conviene definir esos requisitos con el equipo responsable de sistemas antes de elegir el hardware.
¿Una workstation sirve también para entrenar modelos?
Puede utilizarse para desarrollo, entrenamiento o ajuste cuando el modelo y la carga caben en los recursos disponibles. Entrenar modelos grandes desde cero puede requerir infraestructura muy superior. Diferenciamos la tarea concreta para evitar dimensionar el equipo solo por el nombre del modelo.
¿Preparáis equipos para universidades y organismos?
Sí. Podemos estudiar un puesto individual o varios sistemas para tu organización. Indica las especificaciones técnicas y la documentación requerida por tu proceso de compra. La configuración, el plazo y las condiciones se detallan en la propuesta.
Las estrategias de inferencia pueden replicar el modelo o distribuirlo entre GPU; esa diferencia condiciona la memoria necesaria. Documentación de Hugging Face sobre inferencia distribuida.
Define una prueba de IA antes de ampliar el hardware
Para inferencia, describe el modelo, la precisión, el contexto y las solicitudes simultáneas. Distingue tiempo de respuesta de una consulta y volumen de trabajo del servicio. Un resultado medido con un usuario no demuestra el mismo comportamiento con varios.
Para investigación o cálculo, fija software, precisión numérica y un caso representativo. Comprueba qué parte del proceso ocupa CPU, GPU y memoria. Aumentar el número de tarjetas solo tiene sentido si el programa reparte la carga de forma útil y la plataforma puede sostenerla.
Compara un puesto para LLM local con un servidor compartido de inferencia. Si necesitas varias tarjetas, revisa los límites de una plataforma multi-GPU. La guía general de elección te ayuda a comparar propuestas completas.
Cuéntanos tu proyecto.
Preparamos tu propuesta de IA y computación científica.
Desde una workstation hasta varios equipos para tu organización. Cuéntanos en qué trabajas, aunque todavía no tengas una configuración definida.
613 004 811Lunes a viernes · 9:30–17:00 · España y UEOrdenadores predefinidos
Explora en JD Gaming las configuraciones de catálogo para inteligencia artificial. Comprueba GPU, memoria y capacidad de ampliación según tu carga de trabajo.
Inteligencia artificial
Consulta las configuraciones de IA, su memoria y sus opciones de GPU.
Ver ordenadores para Inteligencia artificial en JD GamingJD Workstation y JD Gaming son marcas de Join Digital S.L. Aquí preparamos tu propuesta a medida; en JD Gaming puedes consultar el catálogo y comprar online.
Ver todo el catálogo de workstations