Desarrollo y evaluación
Prepara un entorno para comparar modelos y probar prompts, herramientas e integración con aplicaciones internas.
Diseñamos workstations para trabajar con modelos de lenguaje en la infraestructura de tu organización. Partimos del modelo, su precisión, el contexto y tus aplicaciones para dimensionar GPU, VRAM, RAM y almacenamiento.
Ensamblaje y pruebas en España · Soporte directo · Propuesta a medida
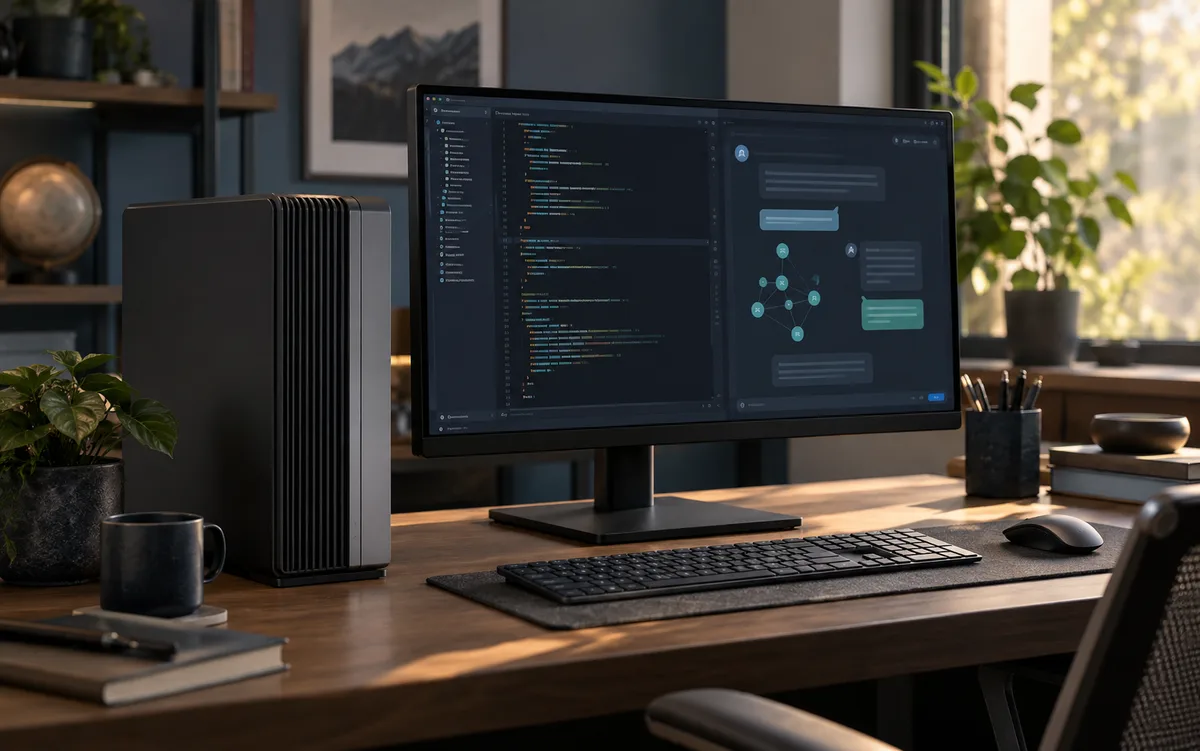
Elegir hardware para un LLM exige concretar qué modelo quieres ejecutar y cómo lo vas a usar. Una prueba individual, un asistente conectado a documentos y un servicio para varios usuarios plantean necesidades diferentes.
Prepara un entorno para comparar modelos y probar prompts, herramientas e integración con aplicaciones internas.
Valora conjuntamente el modelo de lenguaje, embeddings, recuperación de información y volumen documental.
Define qué experimentos y ejercicios deben ejecutarse y si el puesto se comparte entre varias personas.
| Componente | Qué estudiamos | Por qué importa |
|---|---|---|
| Memoria gráfica | Modelo, precisión o cuantización, longitud de contexto y carga simultánea. | Los pesos no son el único consumo: hay que reservar margen para el funcionamiento del modelo. |
| GPU y compatibilidad | Motor de inferencia, librerías y formatos del modelo. | La selección de hardware debe encajar con el entorno de software previsto. |
| CPU y RAM | Preparación de datos, servicios auxiliares y posibles cargas fuera de la GPU. | Valorar RAM adicional no equivale a asegurar el mismo rendimiento que mantener el trabajo en GPU. |
| SSD | Modelos, versiones, documentos y conjuntos de evaluación. | El espacio necesario depende de cuántos recursos se conservan y cómo se usan. |
| Entorno de trabajo | Usuarios, red, controles de acceso y ampliación. | El equipo se integra en las políticas y procesos de la organización. |
La configuración final se concreta en el presupuesto. Las aplicaciones, licencias y servicios incluidos se detallan en cada propuesta.
Indica el modelo o familia que quieres evaluar y la tarea: redacción, clasificación, programación o consulta documental. Si aún no está decidido, podemos preparar alternativas de hardware con sus límites y margen de ampliación. La implantación de aplicaciones, seguridad y mantenimiento se debe concretar en el alcance de la propuesta.
Aplicaciones, carga de trabajo, entorno y prioridades de tu organización.
Configuración y presupuesto con componentes, alcance y condiciones de entrega.
Ensamblaje y pruebas del equipo, con soporte técnico directo.
Depende del modelo, precisión, contexto y uso simultáneo. El tamaño de los pesos es una parte de la estimación; hay que reservar memoria para cachés y ejecución.
Algunos entornos permiten repartir parte del modelo en RAM u otros dispositivos. Esto puede reducir la velocidad; se debe valorar con el modelo y el software concretos.
Permite decidir dónde se procesa la información, pero la privacidad también depende de accesos, aplicaciones, registros, conexiones y políticas de la organización. El hardware por sí solo no la garantiza.
El alcance de software, instalación e integración se detalla en el presupuesto. Indícanos si necesitas solo el equipo o también estudiar esos servicios.
No necesariamente. Entrenamiento, ajuste fino e inferencia tienen necesidades distintas. Debemos conocer la tarea antes de dimensionar memoria y cálculo.
Un ejemplo documentado de reparto de modelos entre dispositivos es Hugging Face Accelerate: Big Model Inference.
Relaciona esta aplicación con el resto de tu trabajo antes de cerrar la configuración.
Preparamos tu propuesta de LLM en local.
Desde una workstation hasta varios equipos para tu organización. Cuéntanos en qué trabajas, aunque todavía no tengas una configuración definida.
613 004 811Lunes a viernes · 9:30–17:00 · España y UEConsulta el catálogo de IA de JD Gaming y compara memoria y GPU para tus modelos locales. La configuración adecuada depende del modelo y su uso.
Consulta las configuraciones de IA, su memoria y sus opciones de GPU.
Ver ordenadores para Inteligencia artificial en JD GamingJD Workstation y JD Gaming son marcas de Join Digital S.L. Aquí preparamos tu propuesta a medida; en JD Gaming puedes consultar el catálogo y comprar online.
Ver todo el catálogo de workstations